


NPU là gì? Tìm hiểu bộ xử lý thần kinh chuyên dụng cho AI

NPU là gì và vì sao laptop, smartphone đời mới đều nhắc đến con chip này? NPU là bộ xử lý chuyên dụng giúp chạy mô hình AI ngay trên thiết bị với mức tiêu thụ điện thấp. Bài viết giải thích cơ chế hoạt động của NPU, ý nghĩa chỉ số TOPS, điểm khác biệt so với CPU, GPU cùng các ứng dụng và giới hạn cần biết.
NPU là gì?
NPU (Neural Processing Unit), hay bộ xử lý thần kinh, là bộ xử lý được thiết kế riêng để tăng tốc các phép toán của mạng nơ-ron nhân tạo. Thay vì xử lý mọi loại tác vụ như CPU, NPU tập trung vào nhóm phép tính lặp lại rất nhiều trong AI: nhân ma trận, tích chập và cộng dồn.
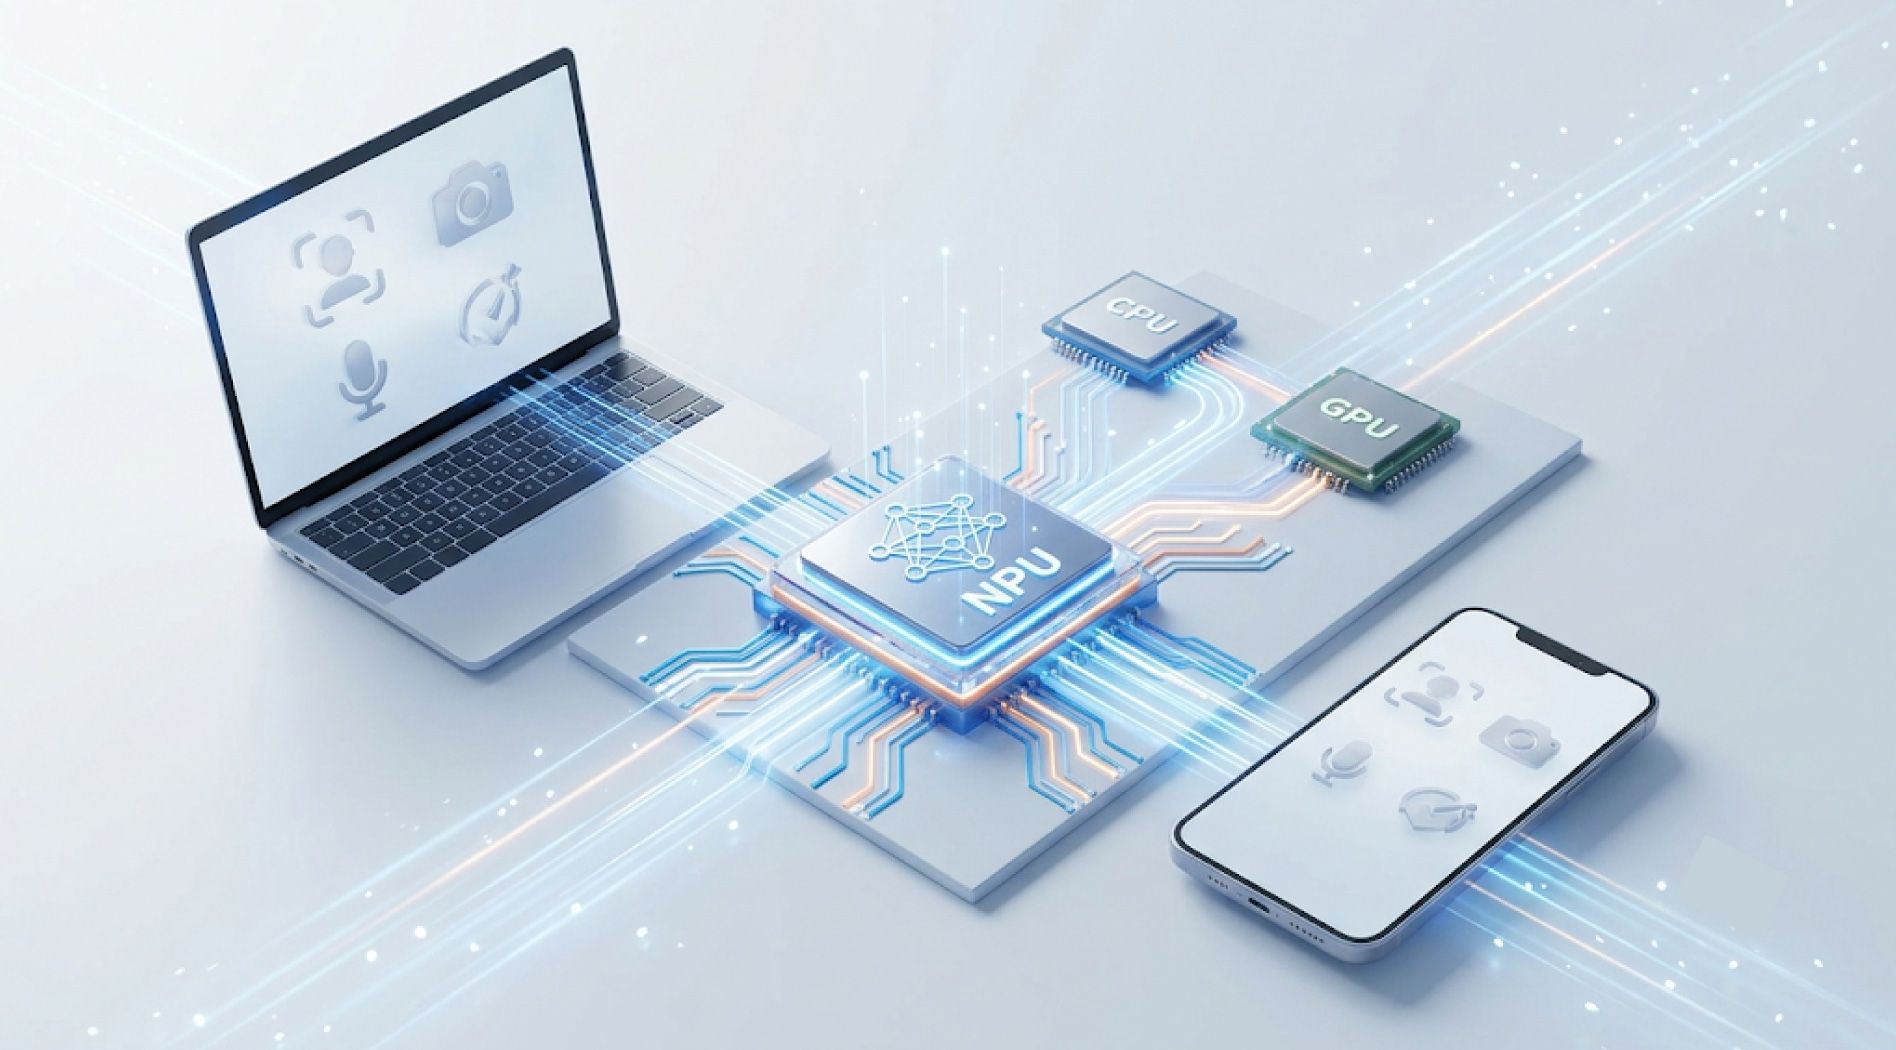
Trên thiết bị tiêu dùng, NPU thường không phải chip rời mà là một khối tích hợp trong SoC (System on Chip), nằm cạnh CPU và GPU. Một số tên gọi phổ biến gồm Apple Neural Engine, Qualcomm Hexagon NPU, Intel AI Boost và AMD XDNA trên dòng Ryzen AI.
Nhiệm vụ chính của NPU là suy luận (inference), tức chạy một mô hình AI đã huấn luyện để tạo ra kết quả, ví dụ nhận diện khuôn mặt, khử ồn giọng nói hay làm mờ hậu cảnh khi gọi video. Việc huấn luyện mô hình lớn vẫn chủ yếu diễn ra trên GPU hoặc chip tăng tốc AI trong trung tâm dữ liệu.
NPU xuất hiện trên smartphone từ năm 2017 với Huawei Kirin 970 và Apple A11 Bionic. Từ năm 2024, NPU trở thành thành phần tiêu chuẩn của AI PC khi Microsoft đặt yêu cầu NPU từ 40 TOPS cho dòng Copilot+ PC.
NPU hoạt động như thế nào?
Hiệu quả của NPU đến từ việc phần cứng được thiết kế bám sát đặc điểm tính toán của mạng nơ-ron. Có ba yếu tố kỹ thuật chính.
Mảng MAC xử lý song song
Phần lớn khối lượng tính toán trong mạng nơ-ron là phép MAC (Multiply–Accumulate): nhân dữ liệu đầu vào với trọng số rồi cộng dồn kết quả. NPU chứa hàng nghìn đơn vị MAC xếp thành mảng, cho phép thực hiện đồng thời rất nhiều phép tính trong một chu kỳ xung nhịp.
Nhiều thiết kế dùng kiến trúc mảng tâm thu (systolic array), trong đó dữ liệu được truyền lần lượt qua các ô tính toán liền kề. Cách này giúp tái sử dụng dữ liệu và giảm số lần truy cập bộ nhớ.
Tính toán với độ chính xác thấp
Mô hình AI khi huấn luyện thường dùng số thực 32 bit (FP32). Khi triển khai, mô hình có thể được lượng tử hóa (quantization) xuống FP16, INT8 hoặc INT4 mà độ chính xác vẫn ở mức chấp nhận được. NPU được tối ưu cho các kiểu dữ liệu này, nên mỗi phép tính cần ít mạch logic, ít băng thông và ít năng lượng hơn.
Bộ nhớ đặt gần khối tính toán
Trong chip, di chuyển dữ liệu thường tốn năng lượng hơn chính phép tính. Vì vậy NPU tích hợp bộ nhớ SRAM ngay trên chip để giữ trọng số và dữ liệu trung gian, hạn chế truy cập RAM hệ thống. Đây là lý do NPU có thể chạy tác vụ AI liên tục trong nền mà không làm máy nóng hay hao pin nhanh.
So sánh NPU với CPU và GPU
CPU, GPU và NPU không thay thế nhau mà phân chia công việc trong cùng một hệ thống. Bảng dưới đây tóm tắt khác biệt chính giữa ba bộ xử lý.
| Tiêu chí | CPU | GPU | NPU |
| Mục đích thiết kế | Xử lý đa dụng, điều phối hệ thống | Đồ họa và tính toán song song quy mô lớn | Tăng tốc phép toán của mạng nơ-ron |
| Cấu trúc tính toán | Ít lõi, mỗi lõi mạnh, xử lý logic phức tạp | Hàng nghìn lõi nhỏ hoạt động song song | Mảng đơn vị MAC chuyên dụng |
| Tính linh hoạt | Rất cao | Cao, lập trình được qua CUDA, ROCm… | Thấp, phụ thuộc toán tử và phần mềm hỗ trợ |
| Hiệu quả năng lượng với AI | Thấp | Trung bình | Cao |
| Tác vụ AI phù hợp | Mô hình nhỏ, tiền xử lý, logic điều khiển | Huấn luyện và suy luận mô hình lớn | Suy luận liên tục, chạy nền trên thiết bị |
| Vị trí phổ biến | Mọi thiết bị | PC, máy trạm, máy chủ | Smartphone, AI PC, thiết bị biên |
Nói ngắn gọn, GPU phù hợp khi cần sức mạnh tính toán cho mô hình lớn, còn NPU phù hợp khi cần chạy AI bền bỉ trong giới hạn điện năng vài watt.
TOPS là gì? Cách đọc thông số hiệu năng NPU
TOPS (Trillion Operations Per Second) là số nghìn tỷ phép tính mỗi giây mà NPU đạt được về mặt lý thuyết. Intel, AMD, Qualcomm và Microsoft đều dùng chỉ số này để so sánh năng lực AI. Ví dụ, Microsoft yêu cầu Copilot+ PC có NPU từ 40 TOPS trở lên, kèm tối thiểu 16 GB RAM và 256 GB lưu trữ.
Tuy nhiên, TOPS chỉ phản ánh hiệu năng đỉnh. Khi đọc thông số, cần lưu ý các yếu tố sau:
- Kiểu dữ liệu đo: TOPS thường được công bố ở INT8. Cùng một NPU, hiệu năng khi chạy FP16 thường thấp hơn đáng kể.
- Băng thông bộ nhớ: với mô hình ngôn ngữ, tốc độ sinh văn bản thường bị giới hạn bởi tốc độ nạp trọng số từ RAM hơn là sức tính toán.
- Tản nhiệt: máy mỏng nhẹ có thể giảm xung khi tải cao kéo dài, khiến hiệu năng duy trì thấp hơn con số công bố.
- Phần mềm: ứng dụng phải được tối ưu để gọi NPU. Nếu không, tác vụ vẫn chạy trên CPU hoặc GPU.
Ngoài ra, một số nhà sản xuất cộng gộp TOPS của CPU, GPU và NPU thành "TOPS toàn nền tảng". Khi so sánh thiết bị, nên tách riêng con số của NPU.
Ứng dụng thực tế của NPU
NPU phát huy hiệu quả với các tác vụ AI cần phản hồi nhanh, chạy thường xuyên và ưu tiên tiết kiệm pin.
Trên smartphone
NPU hỗ trợ xử lý ảnh chụp như nhận diện cảnh, giảm nhiễu, chế độ chân dung, cùng mở khóa bằng khuôn mặt, nhận dạng giọng nói và dịch chữ trong ảnh.
Trên laptop AI (AI PC)
Trên Windows 11, NPU đảm nhận Windows Studio Effects như làm mờ hậu cảnh, điều chỉnh ánh mắt, lọc tiếng ồn micro, cùng tính năng phụ đề trực tiếp Live Captions. Một số phần mềm sáng tạo nội dung cũng dùng NPU để tách nền hoặc chạy mô hình ngôn ngữ nhỏ ngoại tuyến.
Trên thiết bị biên và IoT
Camera an ninh, robot, xe tự hành và thiết bị công nghiệp dùng NPU để phân tích hình ảnh tại chỗ. Cách làm này giảm lượng dữ liệu gửi về máy chủ, giảm độ trễ và bớt phụ thuộc vào kết nối mạng.
Hạn chế của NPU và khi nào cần hạ tầng cloud
NPU giải quyết tốt bài toán suy luận gọn nhẹ, nhưng vẫn có những giới hạn rõ ràng:
- Quy mô mô hình: NPU trên thiết bị phù hợp với mô hình nhỏ đã lượng tử hóa. Mô hình ngôn ngữ hàng chục đến hàng trăm tỷ tham số vượt quá bộ nhớ và năng lực của thiết bị cá nhân.
- Huấn luyện: NPU tiêu dùng không được thiết kế để huấn luyện mô hình, vốn cần độ chính xác cao hơn và bộ nhớ lớn.
- Hệ sinh thái phân mảnh: mỗi hãng có bộ công cụ riêng như Core ML (Apple), OpenVINO (Intel), Qualcomm AI Engine Direct hay Ryzen AI Software (AMD). ONNX Runtime và Windows ML giúp giảm khác biệt, nhưng việc tối ưu vẫn tốn công.
- Hỗ trợ toán tử: lớp mạng hoặc phép toán mà NPU không hỗ trợ sẽ bị chuyển về CPU hoặc GPU, làm giảm hiệu quả chung.
Vì vậy, nhiều hệ thống AI hiện nay đi theo mô hình lai (hybrid). Tác vụ nhẹ, cần riêng tư chạy trên NPU của thiết bị. Huấn luyện, xử lý dữ liệu lớn và phục vụ mô hình cho nhiều người dùng chạy trên nền tảng cloud, nơi tài nguyên mở rộng theo nhu cầu.
Câu hỏi thường gặp về NPU
NPU có thay thế được GPU không?
Không. NPU tối ưu cho suy luận tiết kiệm điện, còn GPU linh hoạt hơn và phù hợp với đồ họa, huấn luyện cũng như mô hình lớn.
Máy tính không có NPU có dùng được AI không?
Có. Ứng dụng AI vẫn chạy trên CPU, GPU hoặc qua dịch vụ đám mây. Tuy nhiên, một số tính năng gắn với phần cứng, như các tính năng dành riêng cho Copilot+ PC, yêu cầu NPU đạt chuẩn.
Làm sao kiểm tra máy tính có NPU hay không?
Trên Windows 11, mở Task Manager và chọn tab Performance. Nếu máy có NPU và driver được hỗ trợ, mục NPU sẽ xuất hiện cùng tên thiết bị. Ngoài ra, có thể xem trong Device Manager.
NPU và TPU khác nhau thế nào?
TPU (Tensor Processing Unit) là dòng chip tăng tốc AI do Google phát triển, chủ yếu dùng trong trung tâm dữ liệu cho cả huấn luyện và suy luận. NPU là tên gọi chung cho khối xử lý AI, phổ biến nhất trên thiết bị đầu cuối.
Kết luận: NPU là bộ xử lý chuyên dụng cho phép toán mạng nơ-ron, giúp thiết bị chạy AI nhanh và tiết kiệm điện nhờ mảng MAC song song, tính toán độ chính xác thấp và bộ nhớ đặt gần khối xử lý. Khi đánh giá NPU, nên xem TOPS cùng băng thông bộ nhớ và mức hỗ trợ phần mềm. Với bài toán vượt quá khả năng của thiết bị, doanh nghiệp có thể kết hợp Cloud Server, Cloud Kubernetes và Object Storage của VNPT Cloud để xây dựng hạ tầng linh hoạt.
