VNPT Cloud GPU


VNPT Cloud Backup
VNPT Cloud Box


In-Place Pod Resize chính thức GA ở Kubernetes 1.35: Đổi CPU/Memory không cần restart Pod

Kubernetes 1.35 khép lại hành trình 8 năm của một tính năng nhỏ nhưng ảnh hưởng lớn: đổi resource cho container đang chạy mà không cần xoá-tạo lại Pod.
1. Vấn đề: Đổi resource = xoá Pod, tạo Pod mới
Trong phần lớn lịch sử Kubernetes, spec.containers[*].resources là bất biến sau khi Pod được tạo. Muốn tăng CPU limit hay giảm memory request? Không có chuyện "sửa tại chỗ" - cách duy nhất là sửa spec (trực tiếp hoặc qua Deployment/StatefulSet), và Kubernetes sẽ xoá Pod cũ, tạo Pod mới với resource mới.
Với Deployment stateless, chuyện này thường chỉ gây gián đoạn nhẹ nhờ rolling update. Nhưng với StatefulSet chạy database, message queue, hay batch/training job chạy nhiều giờ, recreate Pod đồng nghĩa với:
- Container bị kill và khởi động lại từ đầu — mất toàn bộ state, cache, connection pool đang mở trong process
- Scheduler phải tìm Node mới, có thể Pod bị đẩy sang Node khác, ảnh hưởng affinity, local storage, warm cache
- Với AI training job chạy hàng giờ, resize sai một lần = mất toàn bộ tiến độ đã chạy
- Vẫn phải cân nhắc PodDisruptionBudget, readiness probe, thời gian pull lại image
Đây cũng là lý do Vertical Pod Autoscaler (VPA) - công cụ tự động đề xuất và áp resource - trước đây chỉ chạy ở chế độ Recreate: mỗi lần áp khuyến nghị là một lần Pod bị tạo lại. Nhiều team vì vậy ngại bật auto-scaling chiều dọc cho workload quan trọng.
2. Cơ chế hoạt động
Về bản chất, In-Place Pod Resize thay đổi ba thứ:
1. spec.containers[*].resources trở thành mutable — nhưng chỉ cho CPU và memory. Các resource khác (GPU, custom resource qua DRA...) vẫn không đổi được tại chỗ.
2. Subresource /resize mới — thay vì PATCH thẳng vào Pod, bạn PATCH vào Pod/resize. Đây là cổng riêng cho yêu cầu đổi resource, tách biệt khỏi các thay đổi spec khác.
3. status.containerStatuses[*].resources phản ánh resource thực tế container đang có — khác với spec.resources là resource mong muốn. Hai giá trị này có thể lệch nhau tạm thời trong lúc kubelet xử lý.
Luồng xử lý một yêu cầu resize:
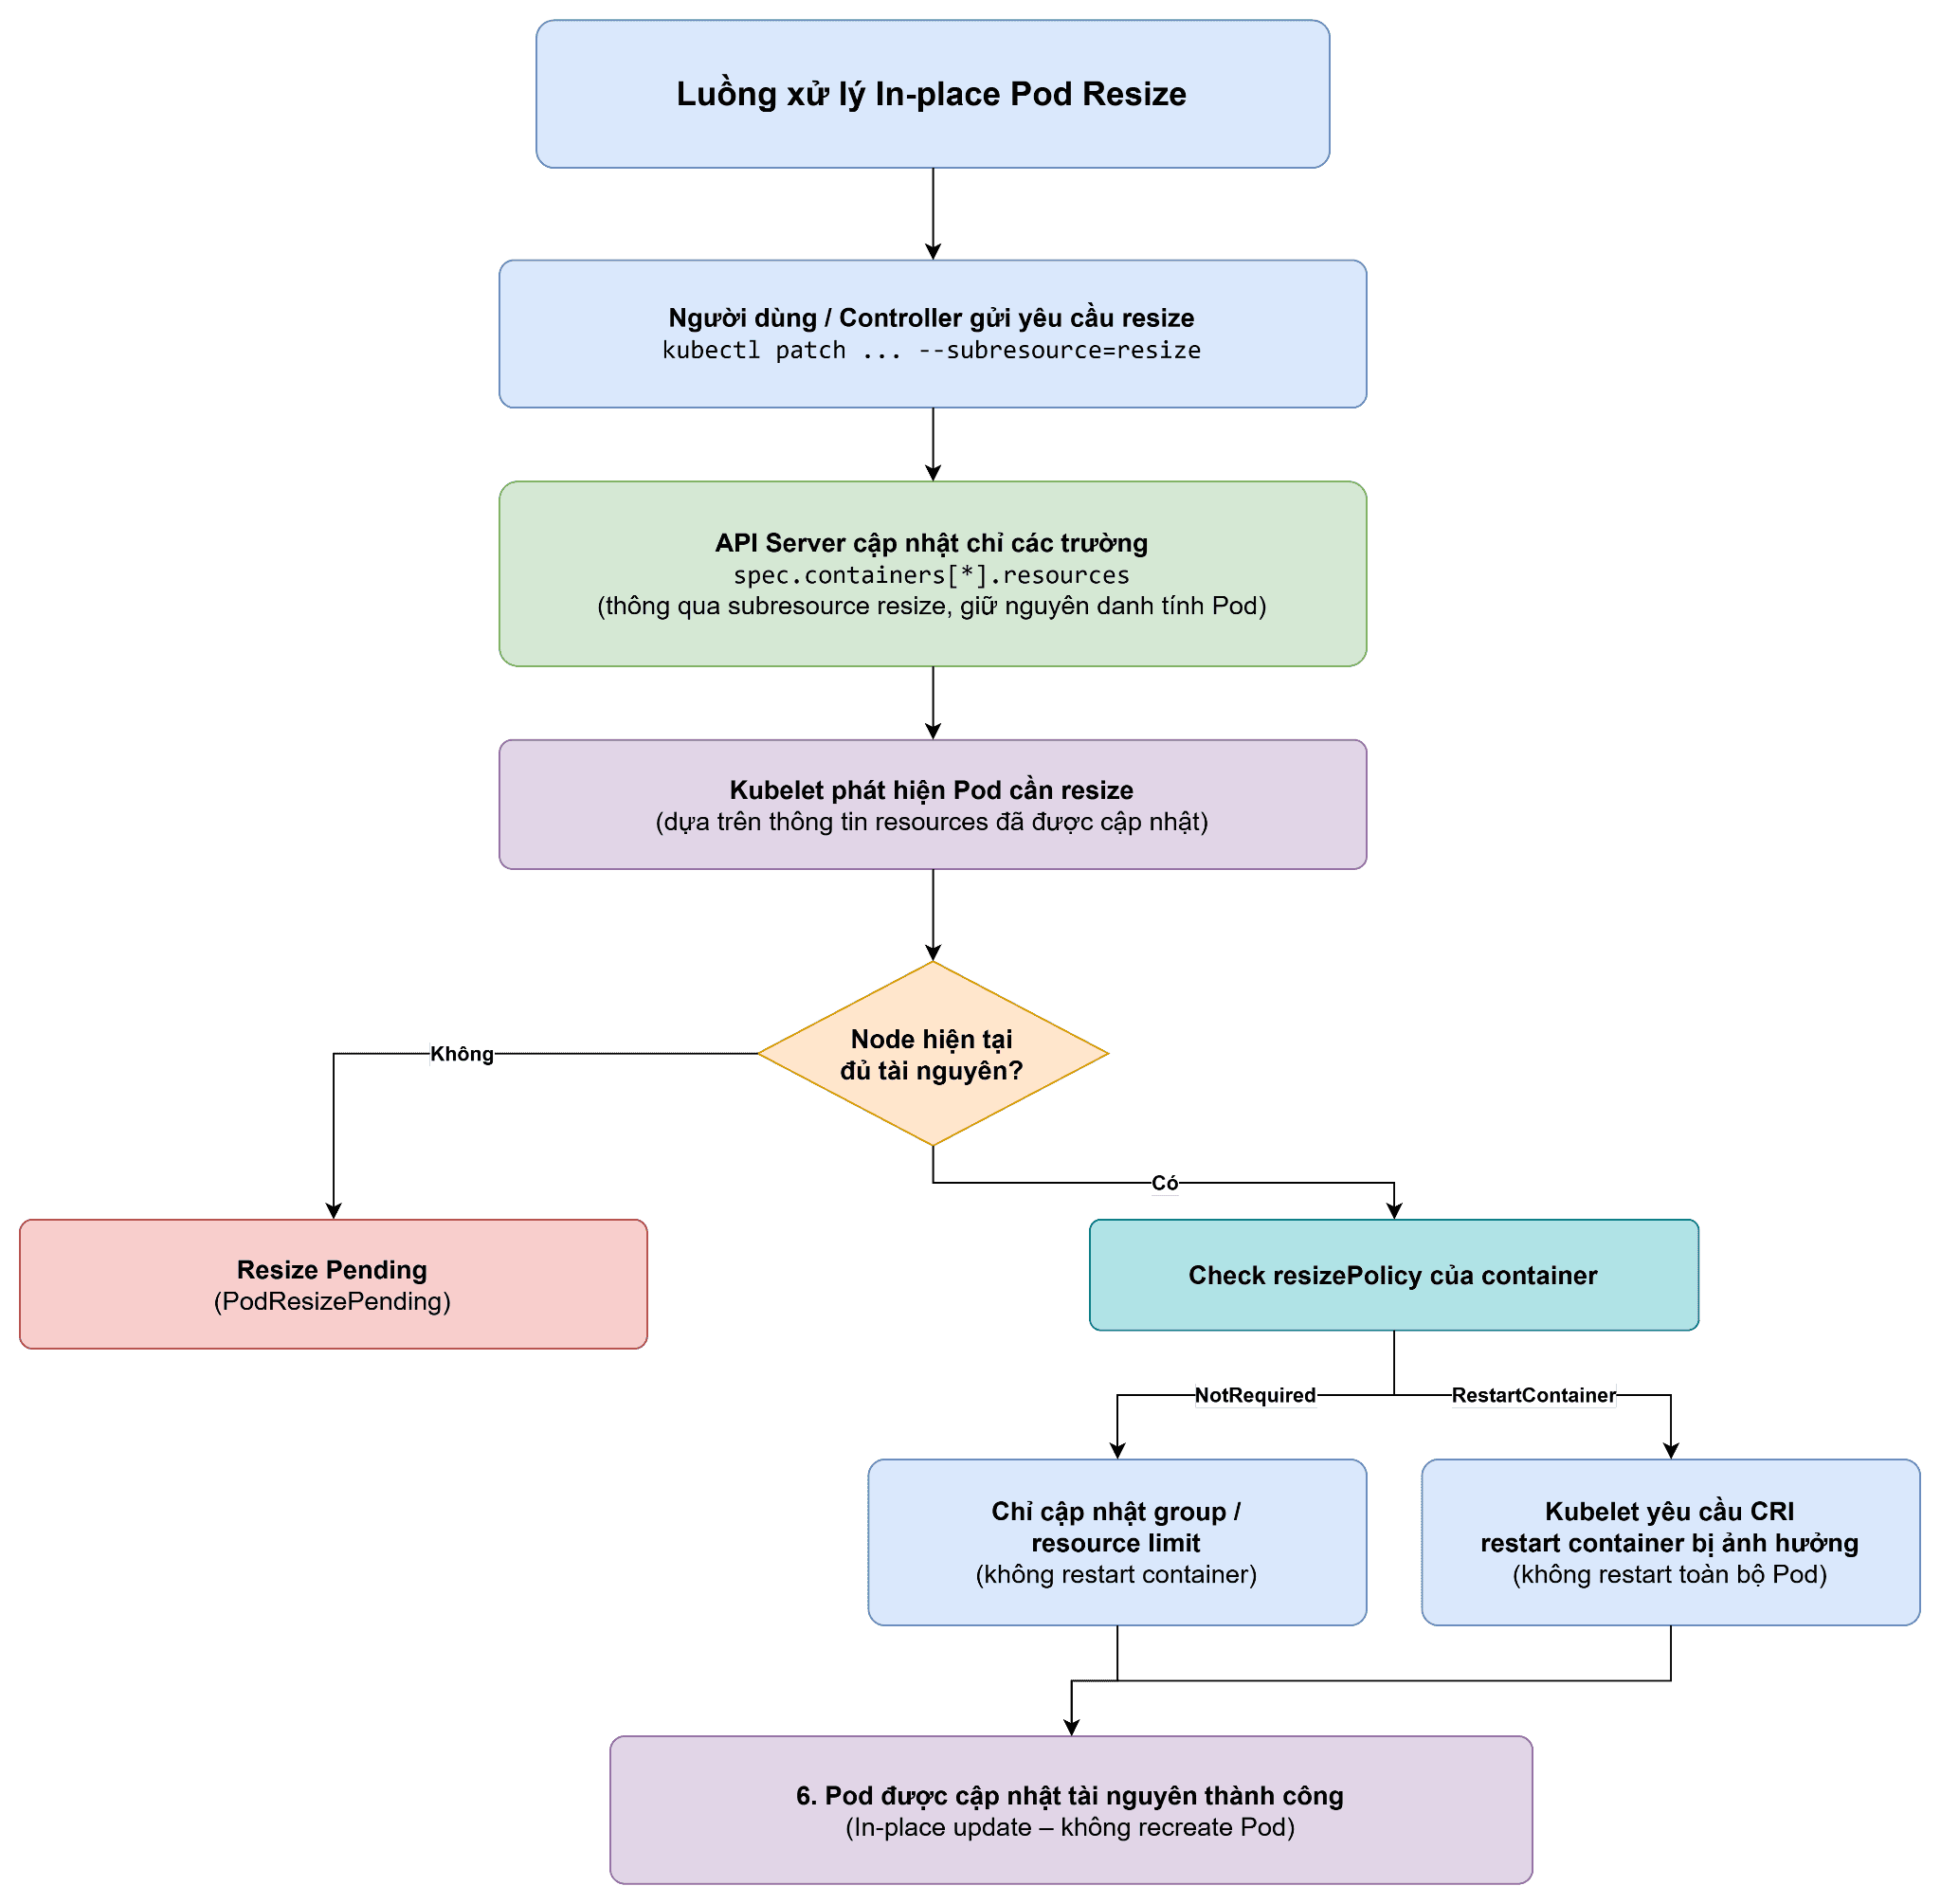
Lưu ý: Resize diễn ra ở cấp Node hiện tại — Kubernetes không tự di chuyển Pod sang Node khác để nhường chỗ. Node không đủ tài nguyên → resize bị treo ở PodResizePending.
Các trạng thái resize chi tiết (từ 1.33+):
Pod có thêm hai loại điều kiện (condition) riêng để theo dõi tiến trình resize:
- PodResizePending — kubelet chưa thể đáp ứng yêu cầu ngay. Trường message cho biết lý do cụ thể:
- reason: Infeasible — không thể thực hiện trên Node hiện tại (yêu cầu vượt quá tài nguyên tối đa Node có thể cấp)
- reason: Deferred — chưa thể ngay nhưng có thể thực hiện sau (ví dụ sau khi Pod khác bị xoá giải phóng chỗ); kubelet sẽ tự động retry
- PodResizeInProgress — kubelet đã chấp nhận yêu cầu và cấp phát resource, nhưng thay đổi đang được áp dụng. Nếu có lỗi, sẽ thấy reason: Error trong message.
3. Khi nào In-Place Resize thực sự hữu ích
Vài tình huống thực tế mà tính năng này phát huy tác dụng rõ nhất:
- Database: một instance PostgreSQL đột nhiên cần thêm memory để chạy một report nặng. Trước đây bạn buộc phải restart Pod, gây downtime và rớt kết nối. Giờ có thể tăng resource tại chỗ, người dùng không nhận ra gì.
- Web app stateless: app Go/Python tận dụng CPU/memory mới ngay lập tức, không cần restart — phù hợp để hấp thụ traffic spike đột ngột. Lưu ý: với Node.js, chỉ tăng memory limit của Pod là chưa đủ — cần đổi thêm tham số --max-old-space-size thì app mới thực sự dùng được phần bộ nhớ mới. Với JVM cũng tương tự như đã nói ở trên — tham số -Xmx chỉ đọc lúc khởi động.
- ML service: service chạy TensorFlow cần thêm resource đột xuất khi phải phục vụ model lớn hơn hoặc lượng request tăng cao, có thể được bổ sung ngay mà không phải restart.
- Sidecar proxy trong service mesh: tinh chỉnh resource cho Envoy proxy (Istio...) để xử lý traffic spike, mà không đụng đến app chính — rất hữu ích vì traffic qua mesh vốn khó đoán trước.
4. Trước và sau: cùng một thao tác, hai cách làm
4.1. Trước đây — buộc phải recreate
Giả sử bạn có Pod chạy CPU limit 500m, muốn tăng lên 800m:
kubectl edit pod resize-demo
# Sửa resources.limits.cpu từ 500m thành 800m rồi lưu
# => Nếu là Pod trần: lỗi "field is immutable"
# => Nếu quản lý qua Deployment: pod cũ Terminating,
# pod mới được tạo ra để thay thế
Kết quả: container cũ nhận SIGTERM, mọi state trong bộ nhớ mất sạch, container mới khởi động lại từ đầu — chỉ để đổi đúng một con số.
4.2. Sau khi có In-Place Resize (GA từ 1.35)
Bước 1: Khai báo resizePolicy khi tạo Pod, chỉ định resource nào được đổi mà không restart:
apiVersion: v1
kind: Pod
metadata:
  name: resize-demo
spec:
  containers:
  - name: app
image: myapp:latest
    resizePolicy:
- resourceName: cpu
      restartPolicy: NotRequired   # CPU: đổi nóng, không restart
- resourceName: memory
      restartPolicy: RestartContainer  # Memory: restart để an toàn
    resources:
      requests:
     cpu: "500m"
        memory: "256Mi"
      limits:
     cpu: "500m"
     memory: "512Mi"
Bước 2: Resize CPU tại chỗ bằng cách PATCH vào subresource resize:
kubectl patch pod resize-demo --subresource resize --type='merge' -p '{
  "spec": {
    "containers": [{
      "name": "app",
      "resources": {
        "requests": {"cpu": "800m"},
        "limits": {"cpu": "800m"}
   }
}]
  }
}'
Bước 3: Kiểm tra kết quả:
kubectl get pod resize-demo -o jsonpath='{.status.containerStatuses[0].resources}'
# => {"limits":{"cpu":"800m",...}, "requests":{"cpu":"800m",...}}

kubectl get pod resize-demo -o jsonpath='{.status.containerStatuses[0].restartCount}'
# => 0   (KHÔNG restart, vì resizePolicy cpu = NotRequired)
Nếu bạn PATCH memory thay vì CPU, restartCount sẽ tăng lên 1 — vì resizePolicy của memory là RestartContainer. Điểm mấu chốt: In-Place Resize không có nghĩa là không bao giờ restart, mà là bạn được chọn resource nào cần restart và resource nào không.
5. Bảng so sánh nhanh
| Khía cạnh | Trước 1.35 | Sau khi GA ở 1.35 |
| Cách đổi CPU/Memory | Sửa spec.resources → xoá Pod cũ, tạo Pod mới | PATCH vào /resize subresource, Pod giữ nguyên định danh |
| Container có restart? | Luôn luôn — toàn bộ container trong Pod | Tuỳ resizePolicy — CPU thường không, memory có thể có |
| Kết nối / state trong process | Mất sạch | Giữ nguyên (khi không restart) |
| Lập lịch lại | Có — scheduler tìm Node mới | Không — Pod ở nguyên Node, chỉ cgroup đổi |
| Tốc độ áp dụng | Chậm — phụ thuộc pull image, khởi động app | Nhanh — thường vài giây, kubelet gọi thẳng CRI |
| VPA | Chỉ chạy chế độ Recreate | Có thể chạy InPlaceOrRecreate |
6. Vì sao thay đổi memory lại khó xử lý hơn CPU?
CPU là tài nguyên co giãn tức thời — cgroup chỉ cần đổi quota, container vẫn chạy bình thường. Memory thì khác: giảm memory limit xuống dưới mức đang dùng thực tế → container bị OOM-kill ngay lập tức. Ngược lại, nhiều runtime (đặc biệt JVM) đã cấp phát heap dựa trên giới hạn memory đọc lúc khởi động — tăng limit tại chỗ không tự khiến ứng dụng dùng được phần bộ nhớ mới, trừ khi restart để đọc lại giới hạn.
Vì vậy khuyến nghị phổ biến: đặt resizePolicy cho memory là RestartContainer để an toàn, còn CPU để NotRequired vì rủi ro thấp hơn nhiều.
7. Những giới hạn cần biết trước khi sử dụng
- QoS class của Pod là bất biến: đây là điểm dễ vấp nhất. Nếu Pod đang ở QoS Guaranteed (requests = limits), mà resize khiến requests ≠ limits, request sẽ bị từ chối thẳng dù CPU/memory vốn mutable - vì QoS class không được phép đổi sau khi Pod đã tạo.
- Init container và ephemeral container không hỗ trợ resize tại chỗ
- resizePolicy phải khai báo khi tạo Pod - không sửa được sau khi Pod đã chạy
- Không thể gỡ bỏ một request/limit đã đặt, chỉ đổi giá trị
- Node không đủ tài nguyên → Pod ở PodResizePending cho đến khi có chỗ
- Kubelet áp dụng thay đổi bất đồng bộ, có thể mất vài giây chứ không tức thời
- Pod đang dùng swap → không resize memory tại chỗ được, vẫn cần restart container
- Chưa hoạt động trên Windows node, chỉ Linux
- VPA: cần Vertical Pod Autoscaler bản 1.4 trở lên mới hỗ trợ updateMode: InPlaceOrRecreate - chế độ này dùng chính subresource /resize nên không chạy được trên các bản Kubernetes chưa có subresource này (trước 1.33).
8. Những cải tiến đáng chú ý
- Hỗ trợ giảm memory limit với NotRequired: trước khi áp giới hạn mới, kubelet làm một bước kiểm tra best-effort — nếu container đang dùng vượt mức limit mới, resize sẽ bị chặn và trạng thái giữ ở In Progress thay vì áp bừa gây OOM.
- Feature gate InPlacePodVerticalScalingExclusiveMemory (mặc định tắt) — điều chỉnh static memory policy cho Pod QoS Guaranteed khi resize.
- Bộ metrics mới cho kubelet: kubelet_container_requested_resizes_total, kubelet_pod_resize_duration_seconds, kubelet_pod_infeasible_resizes_total, kubelet_pod_pending_resizes, kubelet_pod_in_progress_resizes, kubelet_pod_pod_deferred_resize_accepted_total
Rất hữu ích nếu bạn muốn dựng dashboard theo dõi hiệu quả resize trên cluster.
- Tối ưu thứ tự retry khi nhiều resize bị deferred cùng lúc: ưu tiên Pod có PriorityClass cao hơn trước; cùng mức priority thì Guaranteed được resize trước Burstable; cùng điều kiện thì Pod chờ lâu nhất được xử lý trước.
9. Kết luận
In-Place Pod Resize đạt GA ở Kubernetes 1.35 giải quyết một trong những điểm bất tiện tồn tại lâu nhất của Kubernetes: bạn không còn phải đánh đổi giữa right-sizing tài nguyên và gây gián đoạn service. Với workload stateful, batch job chạy dài, hay kết hợp VPA ở chế độ InPlaceOrRecreate, tính năng này giúp tối ưu chi phí (giảm over-provisioning) khả thi hơn nhiều mà không đánh đổi độ ổn định.