


Telemetry là gì? Cách hoạt động, các loại dữ liệu và ứng dụng

Telemetry là quá trình tự động thu thập và truyền dữ liệu đo lường từ hệ thống ở xa về một nơi tập trung để phân tích. Trong vận hành IT, đây là nguồn dữ liệu cho biết máy chủ, ứng dụng và mạng đang hoạt động ra sao. Bài viết giải thích telemetry là gì, cơ chế hoạt động, các loại dữ liệu chính, vai trò của OpenTelemetry và những lưu ý khi triển khai.
Telemetry là gì?
Telemetry (đo lường từ xa) là quá trình tự động đo, thu thập và truyền dữ liệu từ các nguồn ở xa về hệ thống trung tâm để giám sát và phân tích. Thuật ngữ ghép từ hai gốc Hy Lạp: tele (từ xa) và metron (đo lường). Kỹ thuật này vốn phổ biến trong hàng không, vũ trụ và công nghiệp.
Trong CNTT, telemetry là dữ liệu mà máy chủ, ứng dụng, container, thiết bị mạng và dịch vụ cloud phát ra để mô tả trạng thái của chính chúng. Ví dụ: mức sử dụng CPU, độ trễ API, số lỗi HTTP 5xx hay đường đi của một request qua nhiều microservice.
Khác với dữ liệu thô, dữ liệu telemetry được chủ đích tạo ra (instrument), gắn dấu thời gian và có cấu trúc. Nhờ vậy, dữ liệu từ nhiều nguồn có thể được tổng hợp, truy vấn và đối chiếu với nhau.
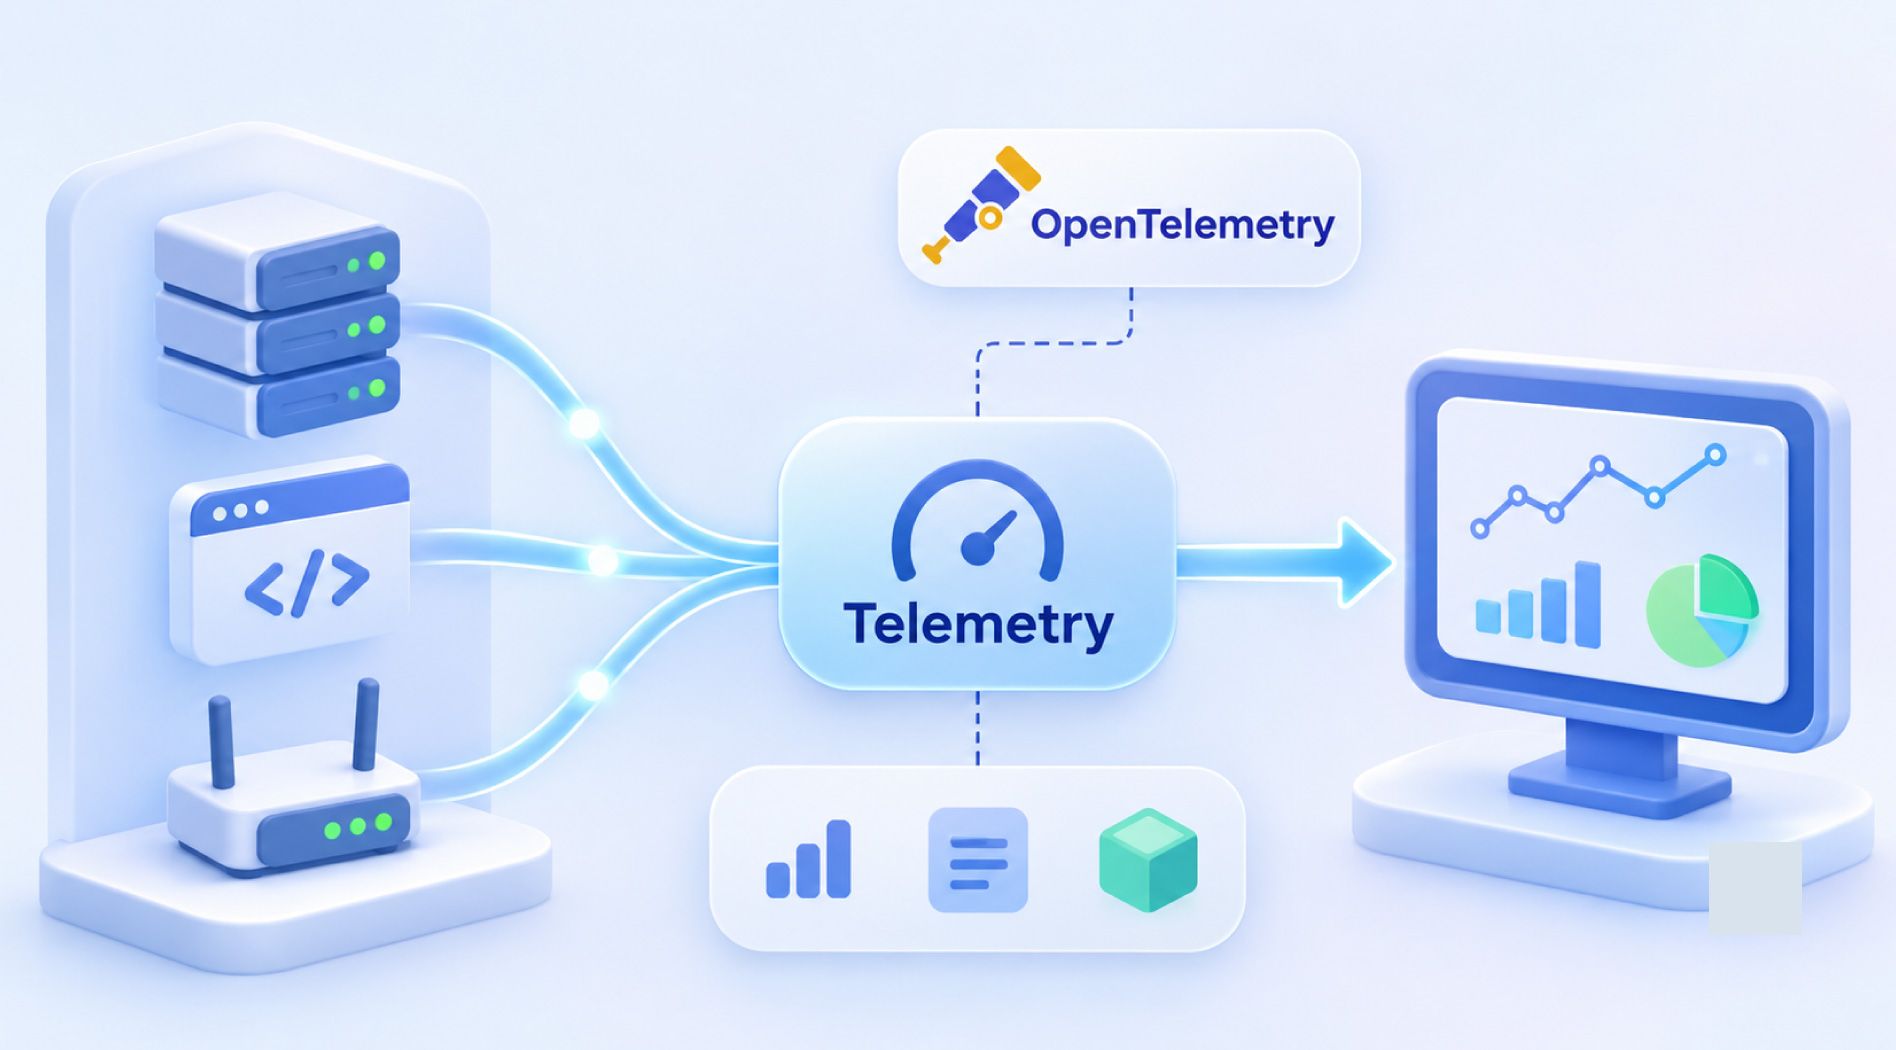
Telemetry hoạt động như thế nào?
Trong hệ thống IT, telemetry thường được tổ chức thành một đường ống dữ liệu (telemetry pipeline) gồm bốn giai đoạn.
1. Instrumentation – tạo dữ liệu tại nguồn
Instrumentation là việc bổ sung khả năng phát dữ liệu cho ứng dụng. Với cách thủ công, lập trình viên gọi API trong code để ghi metric, log hoặc span. Với cách tự động, agent hoặc thư viện chèn vào framework như HTTP server, database client mà không cần sửa code nghiệp vụ. Với hạ tầng, exporter hoặc agent đọc dữ liệu có sẵn từ hệ điều hành, Kubernetes.
2. Thu thập và truyền tải
Dữ liệu được đưa về hệ thống trung tâm theo hai mô hình:
- Pull: hệ thống giám sát định kỳ lấy dữ liệu, ví dụ Prometheus scrape endpoint /metrics của ứng dụng.
- Push: nguồn dữ liệu chủ động gửi đi, ví dụ ứng dụng gửi trace qua giao thức OTLP đến OpenTelemetry Collector.
Với thiết bị mạng, streaming telemetry cho phép thiết bị liên tục đẩy dữ liệu theo cơ chế đăng ký, thường qua gNMI trên nền gRPC, thay cho việc thăm dò định kỳ bằng SNMP.
3. Xử lý và lưu trữ
Trước khi lưu, dữ liệu được lọc, lấy mẫu (sampling) để giảm khối lượng, bổ sung ngữ cảnh như tên service, môi trường, pod và che giấu thông tin nhạy cảm. Metrics thường nằm trong cơ sở dữ liệu chuỗi thời gian, logs trong hệ thống đánh chỉ mục, còn traces cần backend tracing chuyên dụng.
4. Phân tích, trực quan hóa và cảnh báo
Dữ liệu được hiển thị qua dashboard, truy vấn khi điều tra sự cố và đánh giá theo quy tắc cảnh báo. Ví dụ, tỷ lệ lỗi API vượt 2% trong 5 phút sẽ kích hoạt cảnh báo.
Prometheus kết hợp Grafana là bộ công cụ mã nguồn mở phổ biến cho giai đoạn này. Bạn có thể tham khảo hướng dẫn cài đặt Grafana và Prometheus để thấy cách một pipeline metrics được triển khai trên cụm Kubernetes.
Các loại dữ liệu telemetry phổ biến
Dữ liệu telemetry thường được phân nhóm theo mô hình MELT gồm Metrics, Events, Logs và Traces. Gần đây, profiles được bổ sung để phân tích việc dùng tài nguyên đến mức hàm trong mã nguồn.
| Loại | Bản chất | Ví dụ | Câu hỏi trả lời |
| Metrics | Giá trị số đo theo thời gian, đã tổng hợp | CPU 85%, độ trễ p95 là 300 ms | Có bất thường không, mức độ ra sao? |
| Events | Một thay đổi có ý nghĩa tại một thời điểm | Deploy phiên bản mới, pod bị restart | Điều gì vừa thay đổi? |
| Logs | Bản ghi chi tiết do ứng dụng, hệ thống ghi lại | Log mức ERROR báo timeout kết nối database | Hệ thống đã báo gì khi lỗi xảy ra? |
| Traces | Hành trình của một request, gồm nhiều span | Request thanh toán qua gateway, order, payment | Chậm hoặc lỗi ở bước nào? |
| Profiles | Mẫu stack trace thể hiện tài nguyên dùng ở mức hàm | Một hàm xử lý JSON chiếm phần lớn CPU | Đoạn code nào tốn tài nguyên? |
Các tín hiệu này bổ trợ cho nhau: metrics cho biết có vấn đề, traces chỉ ra vị trí, logs và profiles giúp tìm nguyên nhân. Khi log được gắn trace_id của request, kỹ sư có thể đi thẳng từ một span chậm đến đúng các dòng log liên quan.
Telemetry, monitoring và observability khác nhau thế nào?
Ba khái niệm này thường bị dùng lẫn nhưng nằm ở các tầng khác nhau:
| Tiêu chí | Telemetry | Monitoring | Observability |
| Bản chất | Dữ liệu và cơ chế thu thập, truyền tải | Theo dõi các chỉ số đã xác định trước | Khả năng hiểu trạng thái bên trong hệ thống từ dữ liệu đầu ra |
| Câu hỏi chính | Hệ thống phát ra dữ liệu gì? | Có gì vượt ngưỡng hoặc hỏng không? | Vì sao hệ thống hoạt động như vậy? |
| Phạm vi | Đầu vào cho các hoạt động khác | Tình huống đã biết trước | Cả tình huống chưa lường trước |
| Ví dụ | Agent gửi metrics, logs, traces | Cảnh báo khi ổ đĩa đầy 90% | Tìm lý do chỉ một nhóm người dùng bị chậm |
Nói ngắn gọn, telemetry là nguyên liệu. Monitoring dùng nguyên liệu đó để phát hiện vấn đề đã biết, còn observability khai thác telemetry đủ phong phú để trả lời cả những câu hỏi chưa đặt ra từ trước.
Ứng dụng của telemetry trong vận hành hệ thống
- Khắc phục sự cố: cảnh báo sớm khi chỉ số bất thường; traces và logs giúp khoanh vùng nguyên nhân, rút ngắn thời gian khôi phục (MTTR).
- Tối ưu hiệu năng: tìm endpoint chậm, truy vấn database tốn thời gian hoặc service gây nghẽn.
- Lập kế hoạch tài nguyên: dữ liệu CPU, RAM, lưu trữ theo thời gian cho biết khi nào cần mở rộng và khi nào đang cấp phát dư.
- Bảo mật: lưu lượng bất thường hay số lần đăng nhập thất bại tăng đột biến là dấu hiệu cần điều tra.
- Vận hành Kubernetes: pod được tạo và hủy liên tục nên dữ liệu phải gắn nhãn namespace, pod, node. Tham khảo cách thu thập metrics, logs và events của cụm Kubernetes.
Những lưu ý khi triển khai telemetry
Thu thập nhiều dữ liệu hơn không đồng nghĩa với hiệu quả cao hơn. Các nguyên tắc sau giúp hệ thống telemetry hữu ích mà vẫn kiểm soát được chi phí:
- Bắt đầu từ mục tiêu: xác định các chỉ số mức dịch vụ (SLI) như độ trễ, tỷ lệ lỗi, độ sẵn sàng trước khi chọn dữ liệu cần thu.
- Kiểm soát cardinality: mỗi tổ hợp giá trị nhãn tạo ra một chuỗi thời gian riêng. Gắn nhãn như user_id vào metric có thể làm bùng nổ dung lượng lưu trữ.
- Lấy mẫu hợp lý: head sampling quyết định ngay đầu request; tail sampling quyết định sau khi request kết thúc nên ưu tiên giữ được trace lỗi hoặc chậm.
- Phân tầng lưu trữ: dữ liệu chi tiết giữ ngắn hạn, dữ liệu tổng hợp giữ dài hạn; logs cũ có thể chuyển sang object storage.
- Bảo vệ dữ liệu: che thông tin cá nhân, mật khẩu, token trước khi gửi; mã hóa đường truyền bằng TLS.
- Chuẩn hóa ngữ cảnh: thống nhất tên service, môi trường, phiên bản theo semantic conventions của OpenTelemetry.
Câu hỏi thường gặp về telemetry
Telemetry có phải là phần mềm theo dõi người dùng không?
Không. Telemetry là kỹ thuật thu thập dữ liệu, không phải một phần mềm. Trong vận hành IT, telemetry chủ yếu đo trạng thái hệ thống. Khi áp dụng cho ứng dụng của người dùng cuối, nhà phát triển cần công bố rõ phạm vi thu thập và tuân thủ quy định về dữ liệu cá nhân.
Thu thập telemetry có làm chậm hệ thống không?
Có phát sinh overhead, mức độ tùy vào lượng dữ liệu và tỷ lệ sampling. Các SDK hiện đại thường gom dữ liệu theo lô và gửi bất đồng bộ để hạn chế ảnh hưởng đến luồng xử lý chính.
Prometheus và OpenTelemetry khác nhau ra sao?
Prometheus là hệ thống giám sát metrics, gồm cơ chế thu thập, cơ sở dữ liệu chuỗi thời gian, ngôn ngữ truy vấn PromQL và cảnh báo. OpenTelemetry là bộ tiêu chuẩn và công cụ để tạo, thu thập, xuất telemetry, không phải nơi lưu trữ. Hai công cụ thường được dùng cùng nhau.
Kết luận
Telemetry là nền tảng dữ liệu của mọi hoạt động giám sát và observability. Hiểu telemetry là gì, các tín hiệu metrics, logs, traces và cách chúng được thu thập, xử lý giúp đội ngũ kỹ thuật phát hiện sự cố sớm, tối ưu hiệu năng và quản lý chi phí hạ tầng tốt hơn. Với hệ thống chạy trên cloud, kết hợp OpenTelemetry với Prometheus và Grafana trên hạ tầng như Cloud Server hoặc Cloud Kubernetes của VNPT Cloud là cách tiếp cận thực tế để xây dựng khả năng quan sát hệ thống ngay từ đầu.
