VNPT Cloud GPU


VNPT Cloud Backup
VNPT Cloud Box


OpenSearch là gì? Cách hoạt động, tính năng và ứng dụng

Khi nhu cầu tìm kiếm và phân tích dữ liệu ngày càng lớn, OpenSearch trở thành một nền tảng được nhiều đội ngũ kỹ thuật quan tâm. Vậy OpenSearch là gì, hoạt động như thế nào và được ứng dụng trong những trường hợp nào? Bài viết dưới đây sẽ giúp bạn hiểu rõ các nội dung này một cách ngắn gọn và dễ hiểu.
OpenSearch là gì?
OpenSearch là một công cụ tìm kiếm và phân tích dữ liệu mã nguồn mở, được sử dụng để lập chỉ mục, truy vấn và phân tích dữ liệu từ nhiều nguồn khác nhau.
OpenSearch được xây dựng trên Apache Lucene và có nguồn gốc từ Elasticsearch. OpenSearch cung cấp kiến trúc phân tán, có khả năng mở rộng, phù hợp với nhiều nhu cầu như tìm kiếm theo thời gian thực, phân tích log, giám sát hệ thống, observability và phân tích bảo mật.
Bên cạnh công cụ tìm kiếm chính, OpenSearch còn tích hợp OpenSearch Dashboards, giúp người dùng trực quan hóa dữ liệu và theo dõi hoạt động của ứng dụng. Nền tảng cũng hỗ trợ hệ sinh thái đa dạng gồm plugin, API và client, giúp các nhóm kỹ thuật xây dựng và vận hành nhiều quy trình phân tích dữ liệu trong các môi trường hiện đại.
Là một dự án mã nguồn mở với lộ trình phát triển do cộng đồng định hướng, OpenSearch mang lại sự linh hoạt trong quá trình triển khai và hạn chế sự phụ thuộc vào một nhà cung cấp duy nhất. Khả năng tương thích với các phiên bản Elasticsearch trước đây cùng framework plugin có thể mở rộng cũng giúp OpenSearch được ứng dụng trong nhiều trường hợp như phân tích dữ liệu vận hành, pipeline machine learning và các ứng dụng tìm kiếm.
OpenSearch Dashboards là gì?
OpenSearch Dashboards là giao diện trực quan hóa và phân tích dữ liệu của OpenSearch. Công cụ này giúp người dùng khám phá dữ liệu đã được lập chỉ mục, tạo biểu đồ và xây dựng dashboard để theo dõi hệ thống, phân tích bảo mật và giám sát ứng dụng.
OpenSearch Dashboards hỗ trợ nhiều hình thức trực quan như biểu đồ, bảng, bản đồ, notebook và panel tùy chỉnh. Người dùng cũng có thể kết hợp dữ liệu log, metric và trace để theo dõi tình trạng hệ thống và phát hiện bất thường gần theo thời gian thực.
Do có nguồn gốc giao diện từ Kibana, OpenSearch Dashboards khá quen thuộc với những người đã từng sử dụng Elasticsearch và Kibana. Tuy nhiên, công cụ này hiện được phát triển theo lộ trình riêng trong hệ sinh thái OpenSearch.
Các tính năng chính của OpenSearch
OpenSearch được thiết kế để giúp doanh nghiệp lập chỉ mục, tìm kiếm và phân tích lượng lớn dữ liệu theo thời gian thực. Nền tảng sử dụng kiến trúc mã nguồn mở, hướng đến khả năng mở rộng, tối ưu chi phí và dễ tích hợp với nhiều môi trường dữ liệu khác nhau.
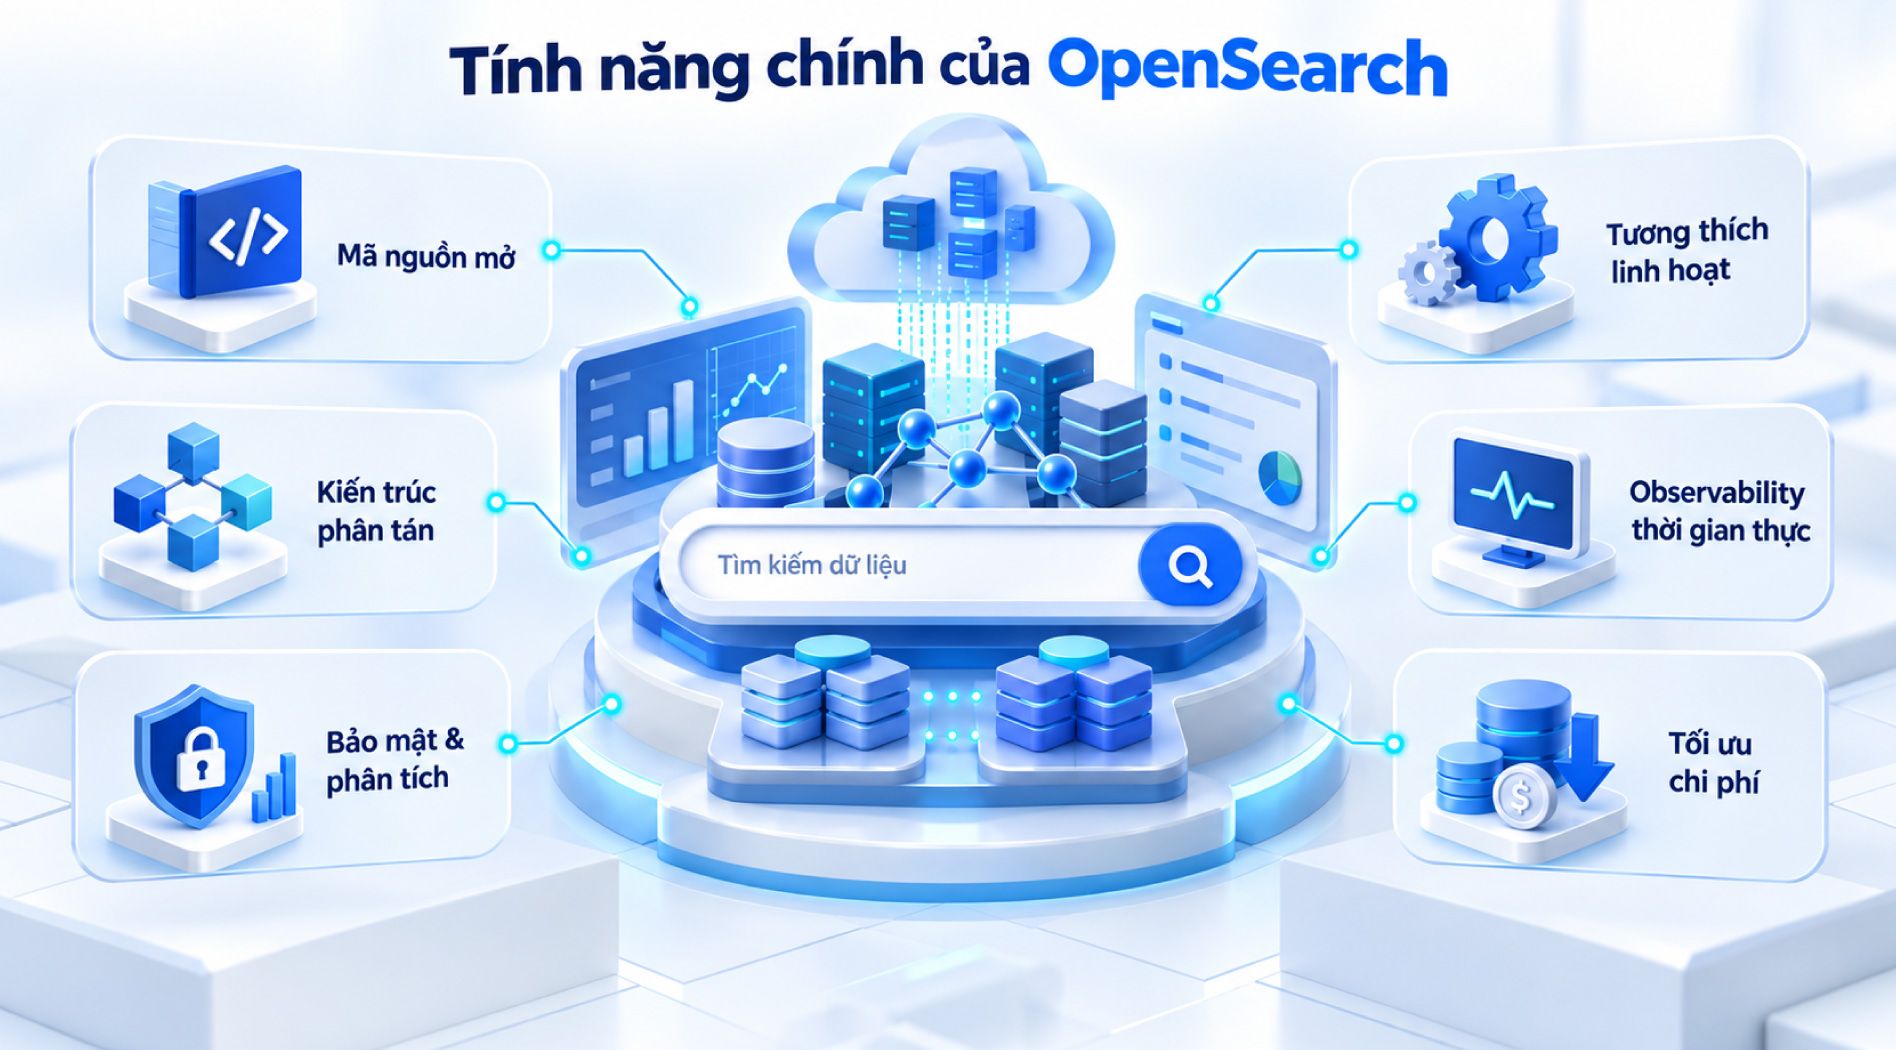
Các tính năng chính của OpenSearch gồm:
- Quản trị mã nguồn mở: Doanh nghiệp có thể theo dõi mã nguồn và lộ trình phát triển của OpenSearch, đồng thời tùy chỉnh nền tảng theo yêu cầu nội bộ.
- Khả năng tương thích linh hoạt: OpenSearch duy trì khả năng tương thích về API và cú pháp truy vấn với Elasticsearch mã nguồn mở, giúp doanh nghiệp chuyển đổi hoặc hiện đại hóa workload mà không phải viết lại toàn bộ hệ thống.
- Khả năng mở rộng và kiến trúc phân tán: OpenSearch sử dụng kiến trúc cluster với các thành phần như node, shard và replica, hỗ trợ tính sẵn sàng cao và khả năng tìm kiếm với độ trễ thấp trên các tập dữ liệu lớn.
- Hỗ trợ observability theo thời gian thực: OpenSearch có thể thu thập và phân tích log, metric và trace ở quy mô lớn. Dữ liệu này có thể được sử dụng trên các dashboard để giám sát hệ thống, phân tích và hỗ trợ xử lý sự cố.
- Tích hợp bảo mật và phân tích: Nền tảng tích hợp các cơ chế xác thực và kiểm soát truy cập, cho phép các nhóm kỹ thuật sử dụng khả năng tìm kiếm và phân tích trong các workload liên quan đến bảo mật.
- Tối ưu chi phí triển khai: Là phần mềm mã nguồn mở, OpenSearch có thể được triển khai on-premises, trên nhiều nền tảng cloud hoặc thông qua các dịch vụ managed. Điều này giúp doanh nghiệp linh hoạt lựa chọn mô hình hạ tầng phù hợp với nhu cầu vận hành và chi phí.
Lịch sử hình thành OpenSearch
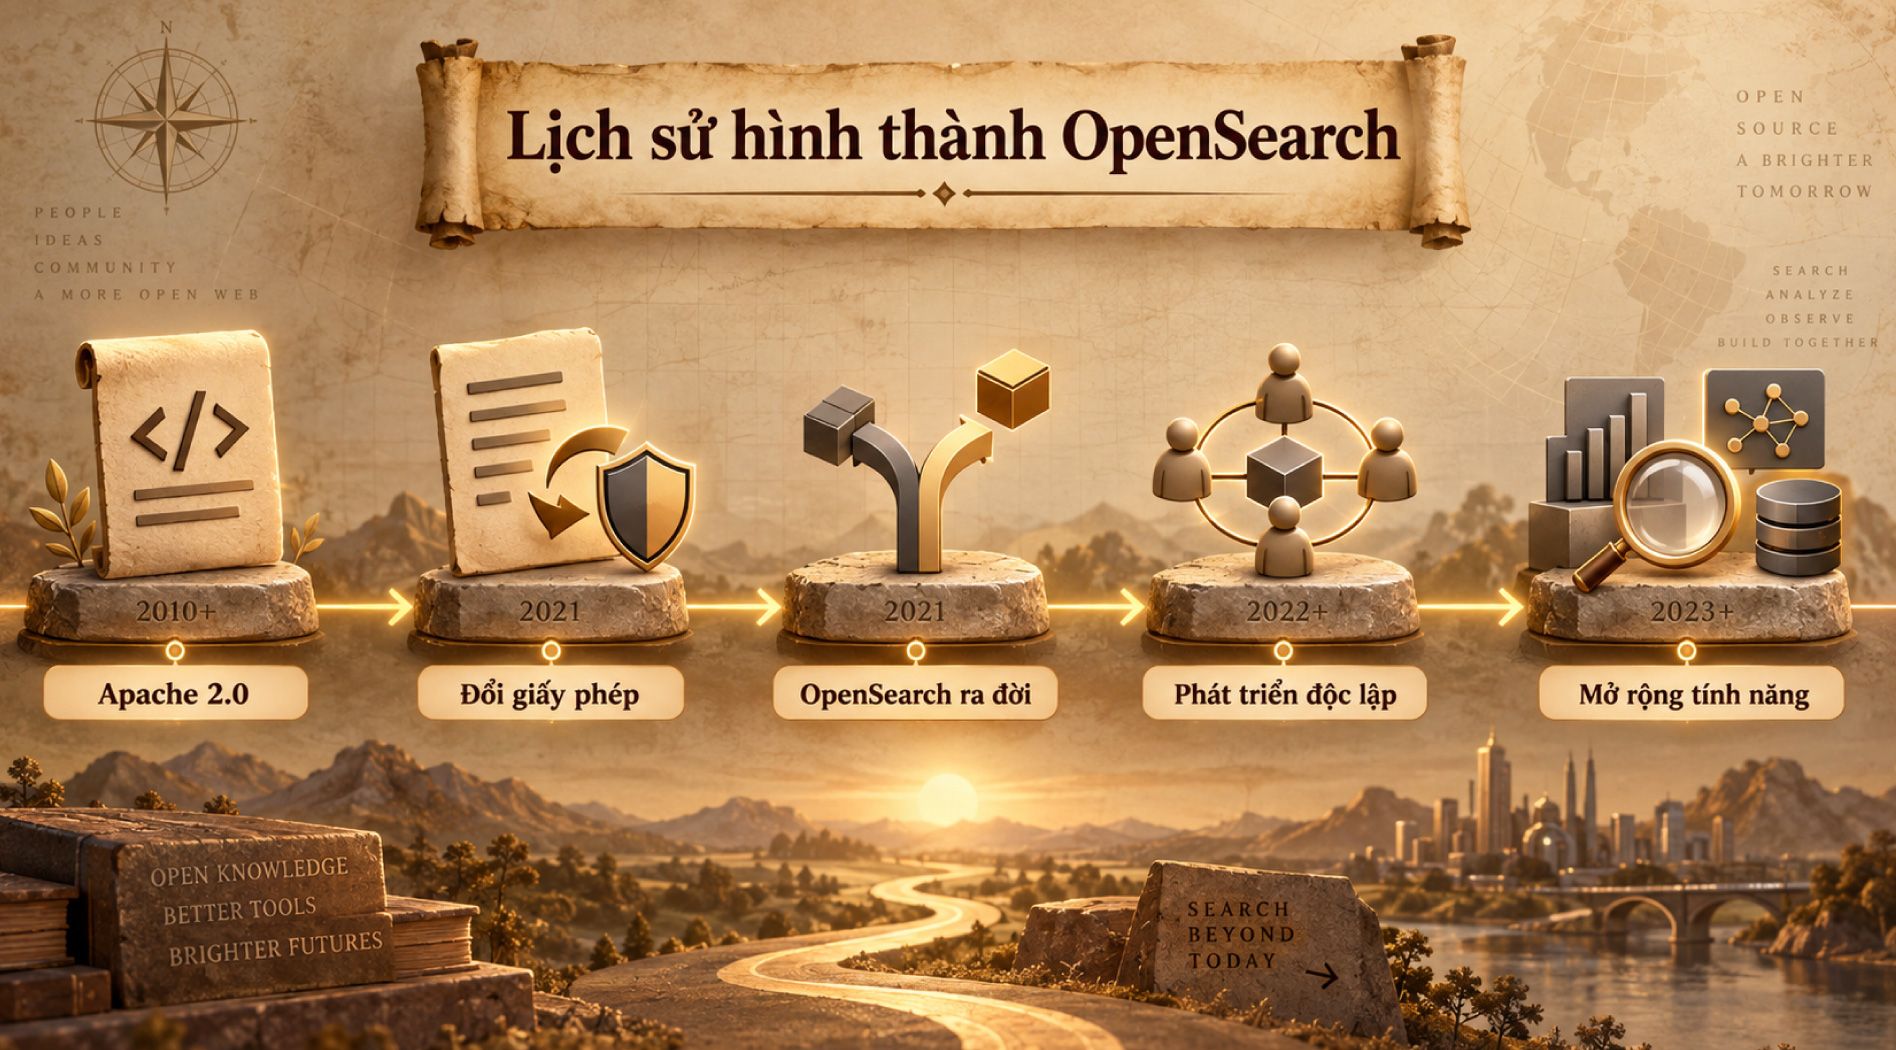
OpenSearch ra đời từ sự thay đổi về giấy phép sử dụng của Elasticsearch và Kibana. Có thể hiểu đơn giản theo các giai đoạn sau:
- Ban đầu, Elasticsearch và Kibana là mã nguồn mở theo giấy phép Apache 2.0: Các tổ chức có thể sử dụng, triển khai và phân phối lại phần mềm khá linh hoạt.
- Sau đó, Elastic thay đổi giấy phép: Elasticsearch và Kibana chuyển sang sử dụng SSPL và Elastic License. Điều này làm thay đổi cách các tổ chức có thể sử dụng và phân phối phần mềm.
- AWS tạo ra OpenSearch: Để tiếp tục duy trì một nền tảng tìm kiếm mã nguồn mở, Amazon Web Services (AWS) đã lấy các phiên bản cuối cùng của Elasticsearch và Kibana còn dùng giấy phép Apache 2.0, sau đó phát triển thành một dự án độc lập có tên là OpenSearch Project.
- OpenSearch tiếp tục phát triển riêng: Sau khi được tách ra, OpenSearch không còn chỉ là một bản sao của Elasticsearch mà được phát triển theo lộ trình riêng, với sự đóng góp từ cộng đồng và nhiều nhà cung cấp.
- Nhiều tính năng mới được bổ sung: OpenSearch vẫn tương thích với nhiều API và cách sử dụng của Elasticsearch, đồng thời mở rộng thêm các tính năng như vector search, phát hiện bất thường và observability.
OpenSearch có giống Elasticsearch không?
OpenSearch và Elasticsearch không hoàn toàn giống nhau. Hai nền tảng có chung nguồn gốc, nhưng hiện đã phát triển theo những hướng riêng.
Tiêu chí | OpenSearch | Elasticsearch |
| Nguồn gốc | Được phát triển từ phiên bản Elasticsearch mã nguồn mở trước đây | Là dự án gốc do Elastic phát triển |
| Giấy phép | Apache 2.0 | SSPL và Elastic License |
| Định hướng phát triển | Ưu tiên tính mở, khả năng mở rộng và cộng đồng | Phát triển theo chiến lược sản phẩm của Elastic |
| Khả năng tương thích | Hỗ trợ nhiều API, cú pháp truy vấn và thư viện client từ các phiên bản Elasticsearch trước đây | Sử dụng hệ sinh thái và công cụ riêng của Elasticsearch |
| Khả năng chuyển đổi | Người dùng Elasticsearch cũ có thể chuyển sang OpenSearch với ít thay đổi hơn trong nhiều trường hợp | Không áp dụng |
Điểm giống nhau lớn nhất là OpenSearch vẫn duy trì nhiều cách làm quen thuộc từ Elasticsearch, chẳng hạn như API, cú pháp truy vấn, cấu trúc repository và định dạng index. Điều này giúp các nhóm kỹ thuật đã sử dụng Elasticsearch trước đây dễ làm quen hơn khi chuyển sang OpenSearch.
Tuy nhiên, khi lựa chọn giữa hai nền tảng, doanh nghiệp không nên chỉ so sánh tính năng mà còn cần xem xét giấy phép sử dụng, mô hình quản trị và định hướng phát triển lâu dài của hệ sinh thái.
Cách hoạt động của OpenSearch
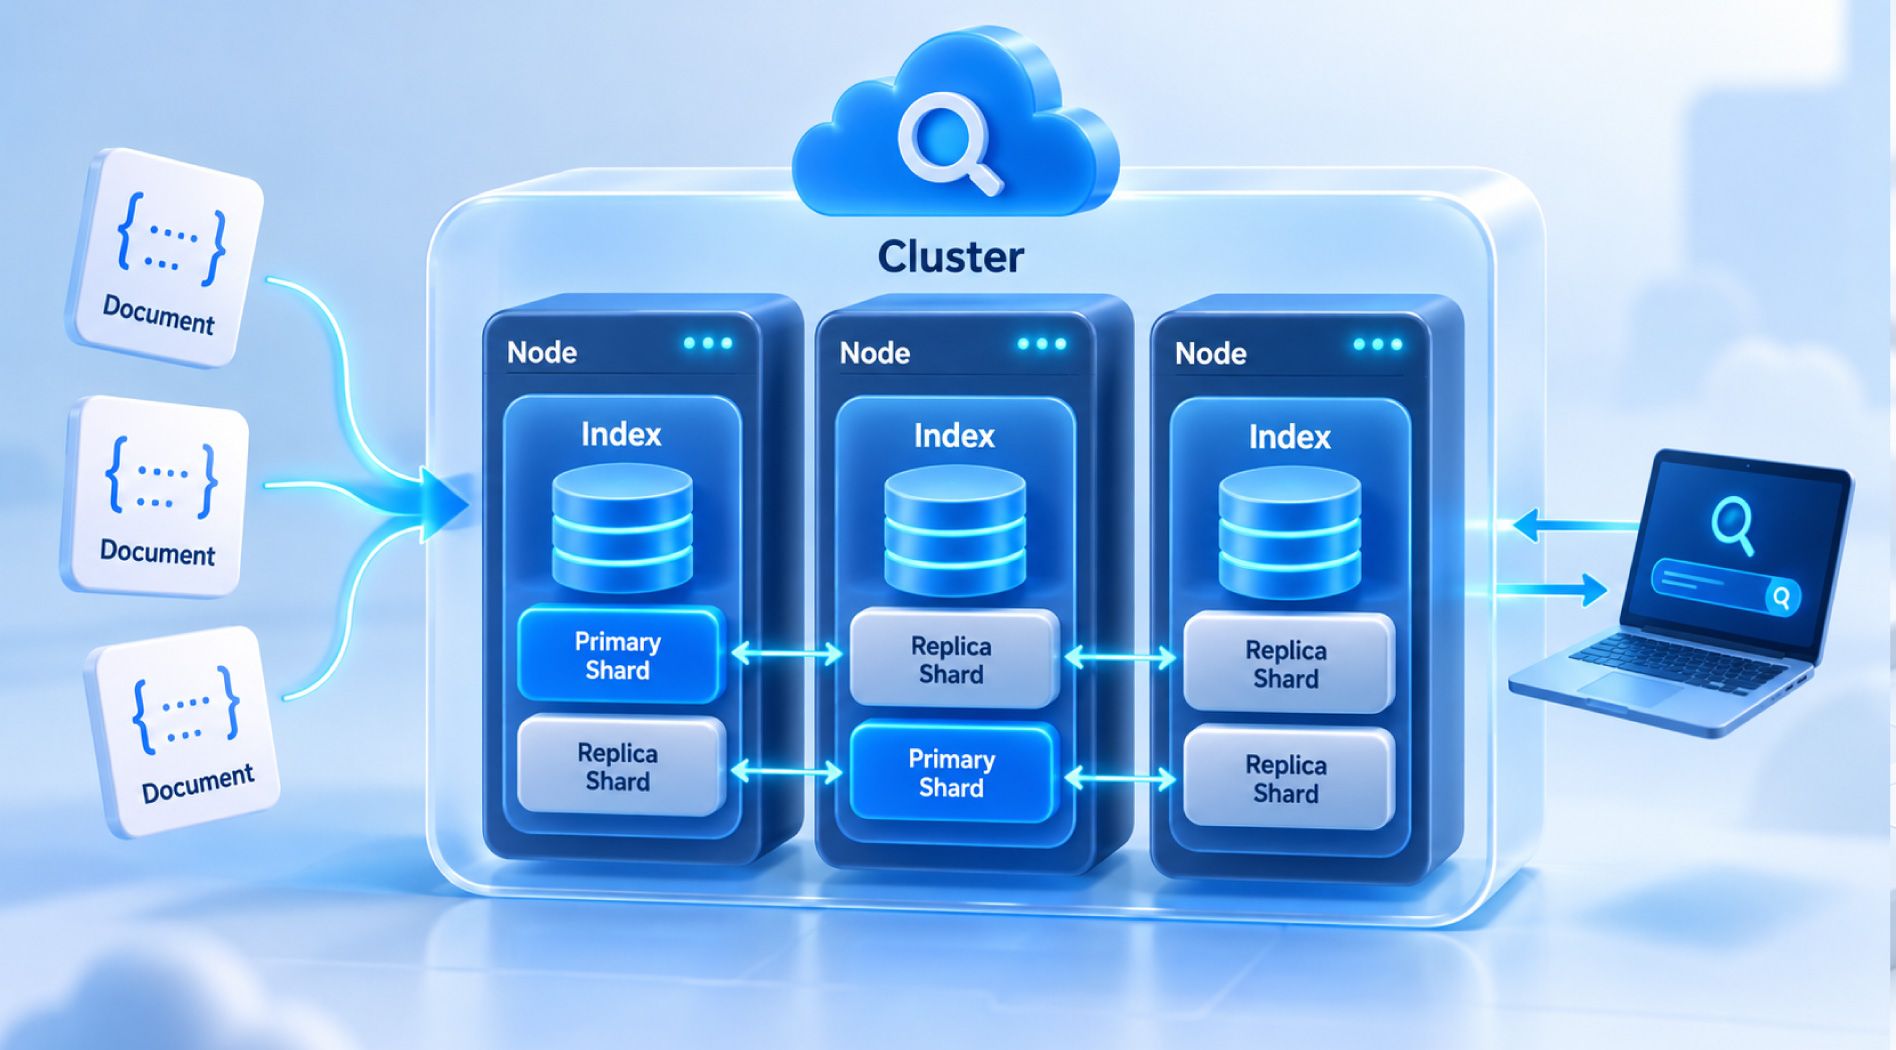
OpenSearch được xây dựng trên một kiến trúc phân tán, được thiết kế để dễ mở rộng và đáp ứng nhu cầu xử lý theo thời gian thực. Các thành phần cốt lõi gồm cluster, node, index, shard và document. Những thành phần này phối hợp với nhau để lưu trữ và truy xuất dữ liệu hiệu quả.
Node
Node là các máy chủ hoặc instance được container hóa, chịu trách nhiệm thực hiện các tác vụ như lập chỉ mục, truy vấn và lưu trữ dữ liệu.
Các loại node phổ biến gồm:
- Master node: Quản lý trạng thái của cluster, điều phối vị trí của shard và duy trì metadata.
- Data node: Lưu trữ document và shard, đồng thời thực hiện các tác vụ lập chỉ mục và tìm kiếm.
- Client node hoặc coordinating node: Điều phối truy vấn tìm kiếm, tổng hợp kết quả và hỗ trợ cân bằng tải mà không trực tiếp lưu trữ dữ liệu.
Cluster
Cluster là một tập hợp gồm một hoặc nhiều node hoạt động cùng nhau để quản lý dữ liệu và xử lý truy vấn.
Cluster hỗ trợ dự phòng và cân bằng tải, nhờ đó sự cố ở một node không làm ảnh hưởng toàn bộ hệ thống. Mỗi cluster cũng duy trì metadata liên quan đến index, shard và thông tin định tuyến dữ liệu.
Index
Index là một không gian logic dùng để tổ chức dữ liệu, có thể hiểu tương tự như một bảng trong cơ sở dữ liệu quan hệ.
Mỗi index chứa các mapping xác định cấu trúc của document JSON và thông tin tham chiếu đến các shard đang lưu trữ những document đó.
Trong OpenSearch, từ “index” cũng có thể được dùng như một động từ để chỉ quá trình đưa dữ liệu vào index.
Document
Document là các đối tượng JSON đại diện cho từng bản ghi dữ liệu riêng lẻ. Nói đơn giản, đây là dữ liệu được OpenSearch lưu trữ và tìm kiếm.
Khi một document được lập chỉ mục, các field bên trong sẽ được phân tích, token hóa và lưu trong inverted index để hỗ trợ tìm kiếm hiệu quả.
Shard
Shard là đơn vị lưu trữ cơ bản trong OpenSearch, nơi các document được lưu trữ. Mỗi index bao gồm:
- Primary shard: Lưu bản dữ liệu chính ban đầu.
- Replica shard: Tạo bản sao dự phòng và giúp tăng khả năng xử lý các truy vấn đọc.
Mỗi shard hoạt động như một instance Lucene độc lập. OpenSearch phân phối các shard trên nhiều node để có thể xử lý truy vấn song song và mở rộng hiệu năng.
Quy trình xử lý dữ liệu trong OpenSearch
Khi một document được đưa vào OpenSearch, hệ thống sẽ phân tích nội dung bằng các text analyzer và tokenizer, sau đó ghi các term đã xử lý vào shard phù hợp.
Quá trình lập chỉ mục được thực hiện bởi các data node và có thể được phân phối trên toàn cluster để tăng tốc độ và độ tin cậy.
Khi người dùng gửi truy vấn, coordinating node sẽ:
- Xác định các shard có chứa dữ liệu liên quan.
- Chuyển truy vấn đến các shard đó.
- Thu thập kết quả từ từng shard.
- Tổng hợp và trả về kết quả cuối cùng.
Có thể hình dung OpenSearch giống như một căn bếp nhà hàng có nhiều khu vực xử lý khác nhau. Quá trình indexing giống như chuẩn bị nguyên liệu và chuyển chúng đến đúng khu vực. Khi có yêu cầu tìm kiếm, coordinating node đóng vai trò điều phối, gọi đúng khu vực cần thiết, thu thập kết quả và ghép lại thành một kết quả hoàn chỉnh.
Các ứng dụng phổ biến của OpenSearch
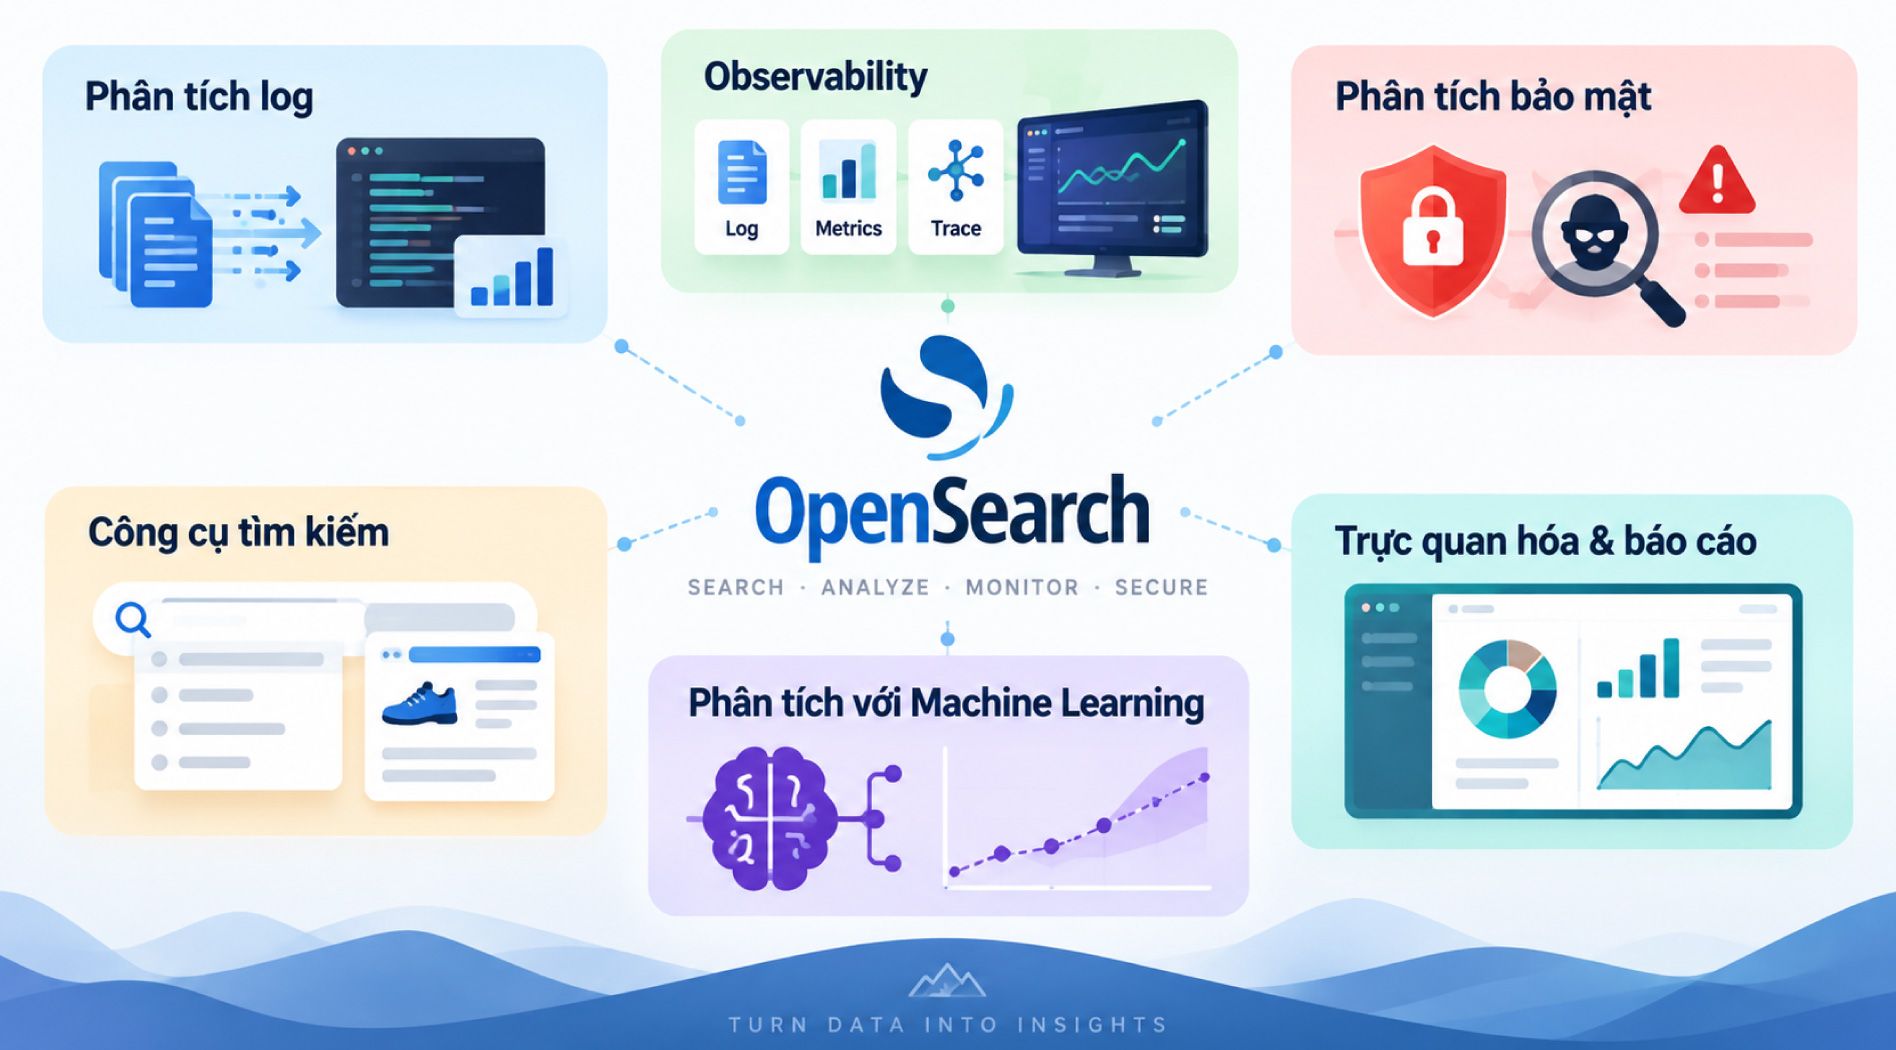
OpenSearch được sử dụng trong nhiều bài toán liên quan đến tìm kiếm, phân tích dữ liệu, giám sát hệ thống và bảo mật. Một số trường hợp sử dụng phổ biến gồm:
- Phân tích log: OpenSearch có thể lập chỉ mục log từ ứng dụng, hạ tầng và dịch vụ cloud để hỗ trợ phân tích hiệu năng và xử lý sự cố. Nền tảng hỗ trợ thu thập lượng lớn dữ liệu và phân tích theo thời gian thực.
- Observability: OpenSearch hỗ trợ dữ liệu log, metric và trace, giúp các nhóm kỹ thuật theo dõi hoạt động của hệ thống, xác định độ trễ và tìm nguyên nhân gây lỗi.
- Phân tích bảo mật và phát hiện mối đe dọa: Các tính năng phát hiện bất thường và Machine Learning có thể được sử dụng để nhận diện các mẫu bất thường trong log xác thực hoặc hành vi ứng dụng, đồng thời gửi cảnh báo khi đạt ngưỡng đã thiết lập.
- Xây dựng công cụ tìm kiếm: OpenSearch có thể được dùng làm search engine cho website, danh mục sản phẩm và hệ thống nội dung doanh nghiệp. Các tính năng như full-text search, autocomplete, phrase matching và vector search hỗ trợ cải thiện trải nghiệm tìm kiếm.
- Trực quan hóa và báo cáo dữ liệu: Thông qua OpenSearch Dashboards, người dùng có thể tạo biểu đồ, theo dõi xu hướng, giám sát KPI và chia sẻ kết quả phân tích.
- Phân tích với Machine Learning: ML Commons hỗ trợ các tác vụ như clustering, classification và forecasting, phục vụ các nhu cầu như phát hiện gian lận, dự báo nhu cầu và phân khúc khách hàng.
Note: ML Commons là thành phần Machine Learning của OpenSearch, hỗ trợ các tác vụ như phân cụm, phát hiện bất thường, dự đoán và các ứng dụng tìm kiếm dựa trên mô hình ML.
Kết luận: OpenSearch là nền tảng tìm kiếm và phân tích dữ liệu mã nguồn mở, hỗ trợ nhiều nhu cầu như tìm kiếm, phân tích log, observability, bảo mật và Machine Learning. Hiểu rõ cách OpenSearch hoạt động và các thành phần chính sẽ giúp doanh nghiệp đánh giá liệu nền tảng này có phù hợp với nhu cầu xử lý và khai thác dữ liệu của mình hay không.